


※本記事は2026年9月時点の公開資料(Microsoft Learn「Chunk Documents – Azure AI Search」、Anthropic「Introducing Contextual Retrieval」)と、当社が社内で動かしている3系統の分割処理を本記事のために検品した結果にもとづきます。数値は当社の検品テストでの実測で、文書や用途によって適切な値は変わります。
「RAG(社内文書を検索して生成AIに答えさせる仕組み)を作ったが、答えが途中で切れる」「根拠に出てくる箇所が微妙にずれる」——原因の多くは、生成AIではなく文書の切り方(チャンク設計)にあります。
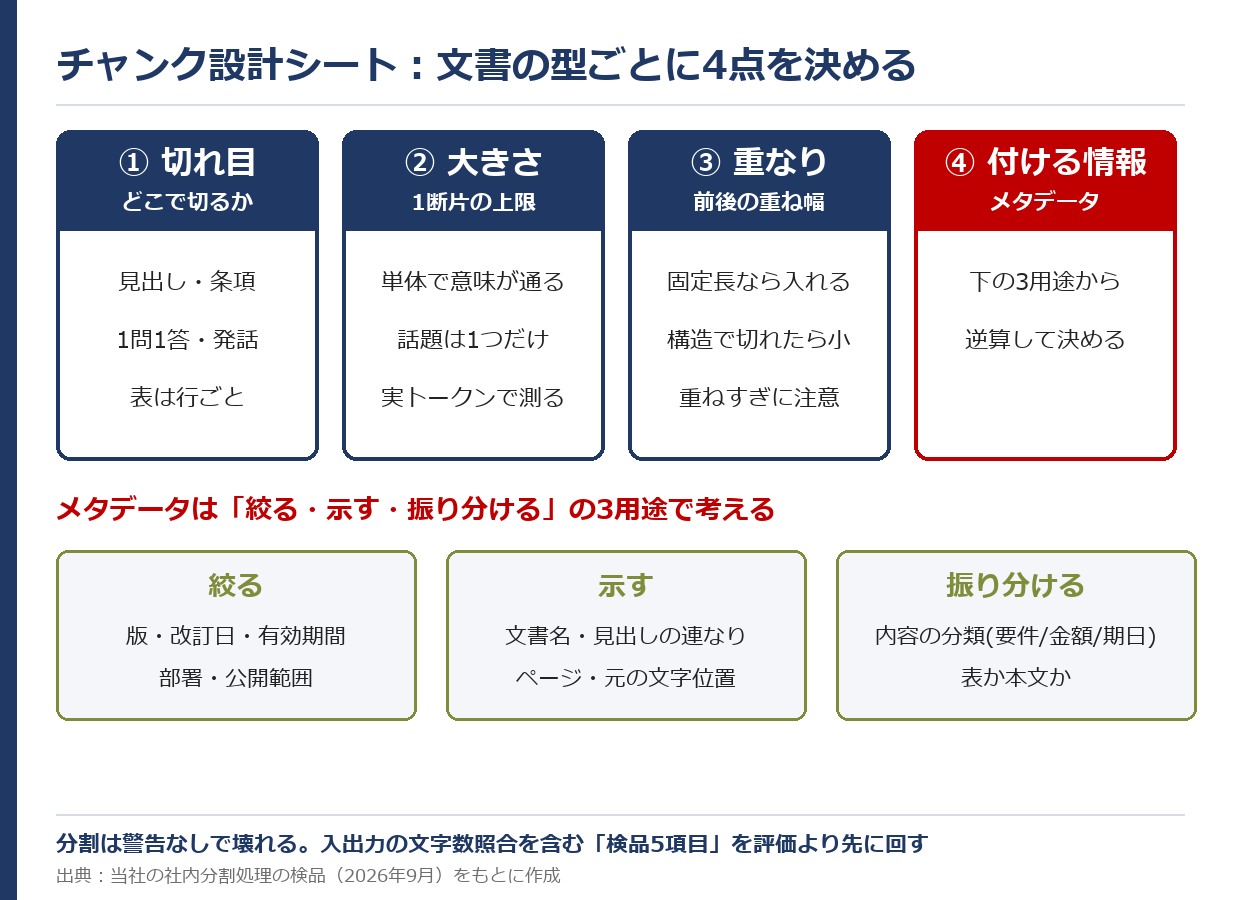
RAGのチャンク設計とは、文書を「どこで切り・どの大きさにし・どれだけ重ね・どんな情報を付けるか」を、文書の型ごとに決めることです。
本記事では、この4点の決め方と、社内文書でつまずきやすい箇所、そして作った分割が壊れていないかを確かめる検品の方法を扱います。RAG全体の作り方はRAG構築の進め方、ハイブリッド検索や再ランクなど精度改善の打ち手全体はRAGの精度を上げる方法にまとめています。本記事は「チャンクの設計と検品」だけを深掘りします。
この記事の結論(30秒サマリ)
– チャンク設計は「切れ目・大きさ・重なり・付ける情報」の4点を、文書の型ごとに決める(当社では「チャンク設計シート」と呼んでいます)。
– 付ける情報(メタデータ)は「絞る・示す・振り分ける」の3用途で考えると漏れない。
– 分割はエラーを出さずに壊れる。当社のコードの検品では、前文が丸ごと消える・見出しだけの断片ができる、といった欠落が警告なしで起きた。入力と出力の文字数を照合する検品を必ず入れる。この記事の監修:大槻 伸夫(キュリオシティ株式会社 代表取締役CEO)。”現場主義 × AI”を掲げ、業務改善(BPR)から生成AIのPoC・社内実装までを一貫して支援。社内でも、問い合わせ回答の下書き、公募要領からの要件抽出、議事録からの要求抽出など、文書を分割して生成AIに渡す仕組みを自ら設計・運用している。
結論:チャンク設計は「4点×文書の型」で決め、文字数照合で検品する
チャンクとは、検索の単位として文書を分けた断片のことです。RAGは質問に近いチャンクを探し、それを根拠に生成AIが答えます。切り方が悪いと、正しい答えが書かれた文書があっても、それを含む断片が見つからないか、見つかっても半分しか入っていません。
当社では、次の4点を文書の型ごとに1行ずつ埋める表を「チャンク設計シート」と呼び、分割処理を書く前に作っています。
| 決めること | 問い | 決めないと起きること |
|---|---|---|
| ① 切れ目 | どこで切るか(見出し・条項・1問1答・発話など) | 条件と例外が別の断片に割れる |
| ② 大きさ | 1断片の上限をどうするか | 小さすぎると主語が消え、大きすぎると検索がぼやける |
| ③ 重なり | 前後をどれだけ重ねるか | 切れ目をまたぐ答えが拾えない、または同じ文ばかりヒットする |
| ④ 付ける情報 | どんな属性(メタデータ)を付けるか | 旧版が混ざる・出典が示せない・処理を振り分けられない |
チャンクはどう壊れるのか?自社の分割コードを検品して分かったこと
分割の失敗はエラーにならず、「少し答えが弱い」という形でしか表に出ません。 これを確かめるため、当社が社内で動かしている分割処理のうち2つに、わざと癖のある文書を入れて出力を確認しました。
固定長(約420字)の分割:見出しの孤立・語の途中切断・主語のない断片
問い合わせ回答の試作では、段落を優先しつつ約420字で区切る単純な分割を使っています。ここに「見出し+500字弱の段落+末尾の一文」からなる返品規定を入れると、4つの断片に割れました。
| 断片 | 文字数 | 中身 | 問題 |
|---|---|---|---|
| 1 | 8字 | 見出し「返品・交換の規定」だけ | 見出しが本文から切り離された |
| 2 | 420字 | 本文の前半。末尾が「30日以」 | 語の途中で切れた |
| 3 | 90字 | 「内に受け付けます。…」 | 何の規定か分からない |
| 4 | 12字 | 「送料は当社負担とします。」だけ | 何の送料かが分からない |
「返品の送料は誰が払う?」と聞かれても、断片4には「返品」という語がありません。キーワードでも意味検索でも拾いにくい断片です。試作のデモには十分でも、本番文書にこのまま使うのは危険だと判断しました。
見出しで切る分割:前文が丸ごと消え、見出しの書き方の違いを取りこぼす
公募要領から要件を抽出する処理では、「5.」「6.2.」のような番号付き見出しを検出して章ごとに分けています。ここに、前文と注記、「1.」「(1)」「①」「2.」「第3条」を混ぜた模擬要領(空白を除いて151字)を入れた結果が次のとおりです。
- 出力は2断片・88字。約4割の文字が消えた。最初の番号見出しより前にあった前文と注記(不正受給時の取り消しなど)が丸ごと落ちた。
- 「(1)」「①」「第3条」は見出しとして認識されず、親の章に吸収された。その結果、「補助対象者」の節は正しい抽出先に振り分けられず、「補助率」は「補助上限額」の章に紛れ込んだ。
どちらも処理は正常終了しています。社内文書では、前文や冒頭の注記に「この規程は○年○月以降の契約に適用する」といった重要な条件が書かれていることが多く、これが消えると検索できないうえに誰も気づきません。
見出しで切る方式が悪いのではありません。「見出しの書き方は文書ごとに違う」「見出しの前にも本文がある」という前提を分割処理に入れておかないと、静かに欠落する、ということです。
文書の型ごとに、切れ目はどう決める?
切れ目は文字数ではなく、その文書で「意味がひとまとまりになる単位」で決めます。 Microsoft Learnの解説でも、固定長のほか、文末や見出しなど文書構造で区切る方法、両者を組み合わせて文書名を途中の断片にも付ける方法が並べて紹介されています。当社では型ごとに次のように決めています。
| 文書の型 | 切れ目 | 一緒に残すもの | つまずきやすい点 |
|---|---|---|---|
| 規程・要領・契約書 | 条・項(見出し番号) | 章・条の見出しの連なり(例:第5章>第12条) | 「第X条」「(1)」「①」など表記の混在。前文・附則 |
| マニュアル・手順書 | 手順のまとまり(STEP単位) | 手順の目的と前提条件 | 手順番号だけの断片ができる |
| FAQ | 1問1答 | 質問文 | 回答だけの断片にすると質問で引けない |
| 議事録 | 発話(または話題の区切り) | 話者・会議名・日付・元の文字位置 | 「それ」「さっきの件」など指示語 |
| 表(料金表・一覧) | 行 | 列の見出しを各行に写す | 表の途中で割れる。PDFから取り出すと列がずれる |
| メール・チャットの履歴 | スレッド | 件名・日付・参加者 | 引用返信で同じ文が何度も入る |
表の扱いはRAG構築の進め方でも触れていますが、実務では「行ごとに切り、各行に列の見出しを写す」と、「A製品の保守料金は?」のような質問で1行だけを正確に引けるようになります。
大きさと重なりはどう決める?
大きさと重なりは、切れ目を決めた後の「上限と保険」です。 構造で切れる文書なら重なりは小さくてよく、固定長で切るしかない文書ほど重なりが必要になります。
出発点としては、Microsoft Learnが「512トークン(約2,000文字)・重なり25%(128トークン)から始める」ことを推奨し、文字数で指定する場合の既定値として「上限2,000文字・重なり500文字」を挙げています。ただし、この「約2,000文字」は英語での換算です。日本語は1文字あたりのトークン数が英語と異なるため、使う埋め込みモデルの計算方法で、自社の文書を実際に数えて決めてください。
当社の判断基準は次の3つです。
- 1断片だけ読んで、何の話か分かるか。 分からないなら小さすぎる。見出しの連なりを断片の先頭に付けるか、大きさを上げる。
- 1断片に複数の話題が入っていないか。 入っているなら大きすぎる。質問に対して関係の薄い部分まで一緒にヒットする。
- 重なりのせいで同じ文が上位を占めていないか。 重なりを大きくしすぎると、検索結果の上位が同じ文を含む断片で埋まり、別の根拠が入らなくなる。
文脈の欠落を補う方法として、Anthropicは各断片に「文書全体の中での位置づけ」を短く書き足してから検索用に登録する手法(Contextual Retrieval)を公開しており、検索の失敗率が下がったと報告しています。手法の詳細と効果はRAGの精度を上げる方法で扱っています。
メタデータは何を付ける?「絞る・示す・振り分ける」の3用途で考える
メタデータは「付けられるものを全部付ける」のではなく、何に使うかから逆算します。 当社の実装を整理すると、用途は3つに分かれました。
| 用途 | 何に使うか | 付ける項目の例 |
|---|---|---|
| 絞る | 検索の前に対象を限定する | 部署、文書の種類、版・改訂日、有効期間、公開範囲 |
| 示す | 回答に根拠を示し、正しいかを確かめる | 文書名、見出しの連なり、ページ、元の文字位置 |
| 振り分ける | 断片ごとに後の処理を変える | 内容の分類(要件・金額・期日など)、表か本文か |
「示す」:文字位置を持たせると、引用が本物かをコードで確かめられる
議事録から要求を抽出する処理では、1発話を1断片とし、話者と元の文章の中での文字位置を持たせています。こうすると、生成AIが「根拠」として引用した文が原文に実在するかを、コードで照合できます。実在しない引用は確信度を下げて人の確認に回します。ハルシネーション(もっともらしい誤り)への対策として、「出典を示せ」とプロンプトで頼むだけより確実です(考え方は生成AIのハルシネーション対策も参照)。
「振り分ける」:見出しの語で、抽出の指示を切り替える
公募要領の処理では、見出しの語(「補助対象経費」「補助率」など)から断片を分類し、要件・金額・期日それぞれ専用の抽出指示に回しています。前章の検品で見たとおり、見出しを取りこぼすと振り分けも誤るので、振り分けに使うメタデータほど分割の検品が重要です。
「絞る」:版と有効期間は最初から付ける
社内文書で最も多い誤答は、改訂前の古い規程を根拠に答えてしまうものです。版・改訂日・有効期間は、後から付け直すと全件を作り直すことになるため、最初の取り込みで付けておきます。部署ごとの公開範囲も同様です。保存先の選び方はベクトルデータベースの選び方で比較しています。
社内文書特有のハマりどころは?
公開Webの文書と違い、社内文書には次の癖があります。どれも「分割の前」に手を打つ必要があります。
- 前文・冒頭の注記・附則に重要な条件がある:適用範囲や経過措置が本文の外に書かれている。見出し前の本文を捨てない。
- 「前項の場合」「同上」「別表参照」:断片単体では意味が通らない。参照先の見出しを書き足すか、参照関係ごと1断片にする。
- 旧版と新版が同じフォルダにある:ファイル名の「_最新」「_v3」は当てにならない。取り込み前に正の版を決める(文書管理の整え方は文書管理システムの選び方)。
- 社内の略語・部署名の言い換え:質問は略語、文書は正式名称、というずれで検索に失敗する。略語の対応表を用意する。
- スキャンPDF・画像の表:文字として取り出せていないことがある。取り込み後に文字数がゼロに近い文書を一覧で確認する。
分割が壊れていないかはどう検品する?「チャンク検品5項目」
分割処理を書いたら、検索や回答の評価より前に、断片そのものを検品します。 当社の検品テストで見つかった欠落はいずれもエラーを出さなかったため、次の5項目を機械的に確認するようにしています。
| # | 確認すること | 見つかる問題 |
|---|---|---|
| 1 | 入力と出力の文字数(空白を除く)が一致するか | 前文や見出し前の本文の欠落(前述の151字→88字) |
| 2 | 短い断片(例:30字未満)の一覧 | 見出しだけ・一文だけの孤立した断片 |
| 3 | 長い断片の一覧と、上限に張り付いた断片の数 | 固定長で切られ、語の途中で終わった断片 |
| 4 | 句点(。)以外で終わる断片の割合 | 文の途中での切断 |
| 5 | 想定質問20問で、正解の断片が上位に入るか | 切れ目・メタデータの設計そのものの誤り |
1〜4はコードで数分あれば回せます。5は業務担当者に「実際に聞きそうな質問」と「答えが書いてある箇所」を出してもらって作ります。正解を人が作ることが肝で、ここを生成AIに作らせると、分割の癖と同じ癖を持った正解ができてしまいます。回答品質全体の評価指標はRAGの精度を上げる方法で扱っています。
PoCでは、チャンク設計をどこまでやればよい?
PoC(試験導入)では、対象文書を1〜2種類の型に絞り、その型の設計シートと検品5項目までを作るのが現実的です。 すべての文書型に対応しようとすると、分割の作り込みだけで期間を使い切ります。
私たちが支援する場合も、最初に「どの文書の、どんな質問に答えられればPoC成功とするか」を決め、その文書の型に合わせて切れ目とメタデータを設計します。成功の基準や撤退基準の置き方は生成AIのPoCの進め方、社内問い合わせへの応用は社内問い合わせチャットボットの作り方をご覧ください。
RAGのPoCを、対象文書と成功基準から設計したい方へ
- 生成AI PoC企画テンプレートを無料ダウンロードする(対象業務・対象データ・評価指標・撤退基準を1枚で整理できます)
- 自社の文書でRAGが使えるか相談したい方は、無料相談からお問い合わせください。支援内容は生成AI開発・PoC支援で紹介しています。
よくある質問(FAQ)
Q. チャンクサイズは何文字が正解ですか?
A. 正解の数値はありません。まず切れ目(見出し・条項・1問1答など)を決め、大きさはその上限として決めます。出発点としてMicrosoft Learnは512トークン・重なり25%を推奨していますが、日本語では文字数換算が変わるため、自社の文書を実際に数えて調整してください。
Q. オーバーラップ(重なり)は必ず入れるべきですか?
A. 固定長で切る文書には入れます。見出しや条項で切れる文書では小さくてかまいません。重なりを大きくしすぎると、同じ文を含む断片が検索結果の上位を占めて、別の根拠が入らなくなります。
Q. メタデータは最低限何を付ければよいですか?
A. 文書名・見出しの連なり・版(改訂日)の3つです。文書名と見出しで出典を示せ、版で古い文書を除外できます。部署ごとに見せる範囲が違うなら公開範囲も必須です。
Q. 表はどう分割すればよいですか?
A. 行ごとに切り、各行に列の見出しを写します。PDFから取り出した表は列がずれていることがあるため、取り込み後に数行を目で確認してください。
Q. チャンク設計を変えたら、全文書を作り直す必要がありますか?
A. 切れ目や大きさを変えた場合は、その文書の型の断片を作り直し、検索用の登録もやり直します。だからこそ、PoCの段階で型ごとの設計シートと検品を固めておくと、本番での作り直しが減ります。
まとめ:チャンク設計は「型ごとの4点」と「文字数照合の検品」で決まる
- チャンク設計は、切れ目・大きさ・重なり・付ける情報の4点を文書の型ごとに決める。
- 切れ目は文字数ではなく意味のまとまりで決め、大きさと重なりは上限と保険として後から決める。
- メタデータは絞る(版・部署)・示す(出典・文字位置)・振り分ける(分類)の3用途で考える。
- 分割はエラーを出さずに壊れる。入出力の文字数照合を含む検品5項目を、評価より先に回す。
RAGの検索精度を上げる打ち手は多くありますが、断片そのものが壊れていると、どの打ち手も効きません。まず自社の文書の型を洗い出し、1つの型から設計シートを埋めてみてください。
