「社内のシステムはAWSに載っている。生成AIもAWSの中で使えれば、情シスにもセキュリティ部門にも説明しやすいのでは」——生成AIの相談で、AWSを使っている企業からよく聞く言葉です。その答えの第一候補が、AWSの生成AIサービス「Amazon Bedrock」です。
Amazon Bedrock導入は、「経路・権限・所在・記録」の4点を最初の構成で決めてから、1業務のPoCで始めるのが近道です。
Bedrockは画面からすぐ試せるため、試作までは速く進みます。つまずくのは「本番に出してよいか」を問われたときです。通信はどこを通るのか、誰がどのモデルを使えるのか、データはどの国で処理されるのか、何が記録に残るのか。この4つに答えられないと、試作は情シスの審査で止まります。
本記事では、AWS公式ドキュメント(2026年10月確認)と、当社が社内閉域網での生成AI活用を企業に提案・設計してきた知見をもとに、Bedrockの安全な構成と導入の進め方を整理します。閉域で生成AIを使う選択肢の全体像は閉域網で生成AIを使う方法|セキュアな社内活用で扱っているため、本記事は「AWSを選んだ企業が、Bedrockをどう入れ、どこで止まらないか」に絞ります。
この記事の監修:大槻 伸夫(キュリオシティ株式会社 代表取締役CEO)。業務改善・PMI・生成AI導入の現場支援に携わり、「現場主義 × AI」で業務の可視化から生成AIの試作・定着までを支援。
Amazon Bedrockとは?何ができますか?
Amazon Bedrockは、Anthropic(Claude)やAmazon、Meta、Mistral AIなど複数社の生成AIモデルを、AWSの中から1つの窓口で呼び出せるサービスです。 サーバーを自分で用意する必要はなく、使った分だけ料金を払います。
モデルを呼び出すだけでなく、社内利用に必要な部品がそろっているのが特徴です。
| 機能 | できること | 社内での使いどころ |
|---|---|---|
| 基盤モデル | 複数社のモデルを同じAPIで呼び出す | 用途ごとにモデルを使い分ける |
| ナレッジベース | 社内文書を検索して答える仕組み(RAG)を作る | 規程・マニュアルの問い合わせ窓口 |
| ガードレール | 有害な内容・個人情報・禁止話題を止める | 社外秘や個人情報の出力防止 |
| エージェント | AIが手順を考えて社内システムを操作する | 調べ物や複数手順をまたぐ作業 |
| バッチ推論 | 大量の処理をまとめて安く流す | 過去文書の一括要約・分類 |
※出典:Amazon Bedrock よくある質問、Amazon Bedrock User Guideをもとに当社作成(2026年10月確認)。
選び方の目安は「社内のシステムがどこにあるか」です。 基幹システムや社内文書がすでにAWSにあるならBedrock、Microsoft 365とAzureが中心ならAzure OpenAIが自然です。後者はAzure OpenAIの導入|企業がセキュアに生成AIを使う構成と進め方で解説しています。モデルそのものの違いは生成AI(ChatGPT・Claude・Gemini)の比較|業務用途での選び方を参照してください。
Bedrockに社内データを入れても安全ですか?
AWSは、Bedrockに入力した内容を基盤モデルの改善に使わず、モデルの提供元にも共有しないと明記しています。 ただし、安全に使えるかどうかは、自社側の設定で決まる部分が大きいことも押さえておく必要があります。
公式情報で確認できる主な点は次のとおりです。
- 学習に使われない:入力と出力は基盤モデルの改善に使われず、モデルの提供元にも共有されない(よくある質問)。
- 提供元はログを見られない:モデルはAWSが運用する専用のアカウントに複製されて動き、提供元はそこにアクセスできないため、プロンプトや回答を見られない(データ保護)。
- 保存は利用リージョン内:Bedrockが扱う顧客の内容は暗号化され、利用しているリージョンに保存される(よくある質問)。
一方で、AWSは「責任共有モデル」をとっています。インフラの保護はAWS、誰に使わせるか・どこから通信させるか・何を記録するかは利用企業の責任です。安全性の議論が「Bedrockは安全か」で止まらず、「自社の構成は安全か」に進むのはこのためです。社内ルール側の整え方は生成AIのセキュリティ対策|情報漏えいを防ぐ社内導入の要件にまとめています。
AWSで生成AIを安全に使う構成は?
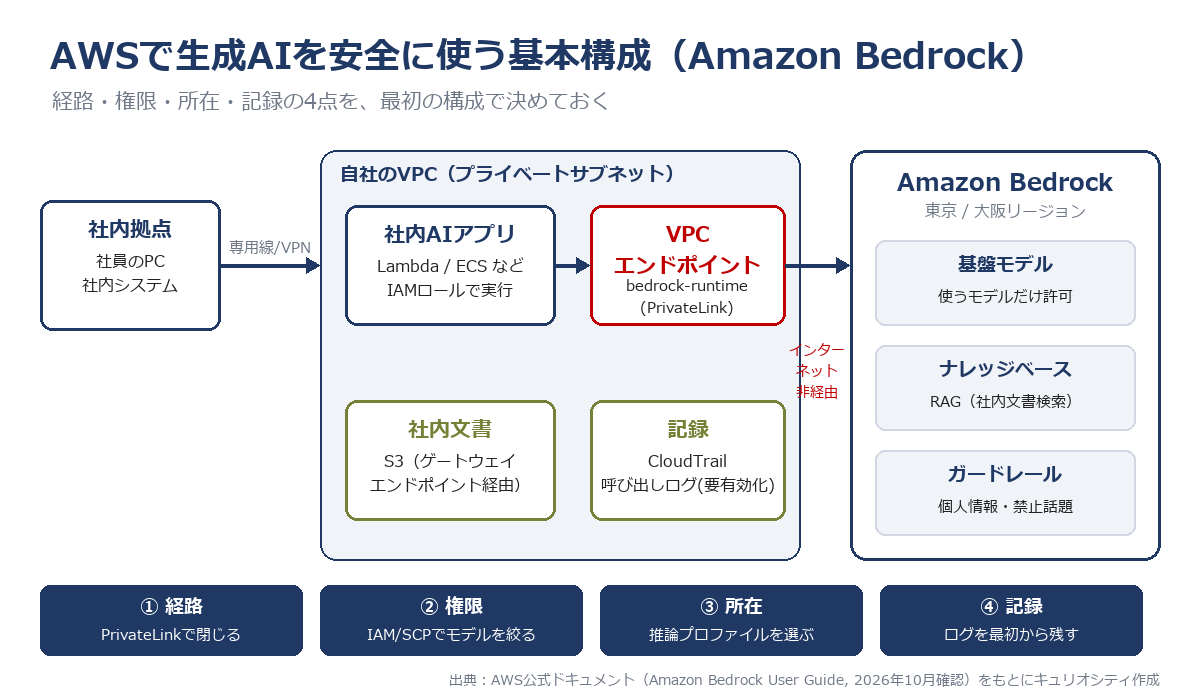
当社は、Bedrockの構成を「経路・権限・所在・記録」の4点で確認しています(Bedrock安全構成4点チェック)。 4点とも、あとから変えると利用者やアプリへの影響が大きいため、PoCの段階から本番と同じ考え方で決めておきます。
当社が製造業の企業に社内閉域網での生成AI活用を提案した際も、最初に問われたのは「データは外に出るのか」「誰が使えるのか」「どこに記録が残るのか」の3点でした。モデルの性能比較は、その後です。4点チェックは、この問いに先回りして答えるための型です。
① 経路:PrivateLinkでインターネットを通さない
VPCエンドポイント(AWS PrivateLink)を作ると、自社のVPCからインターネットを経由せずにBedrockを呼び出せます。 公式ドキュメントでは、インターネットゲートウェイもNATも不要で、VPC内のサーバーは公開IPを持たなくてよいとされています。
2026年10月時点の公式ドキュメントでは、Bedrock向けのエンドポイントは用途別に5種類(米国の政府調達向けFIPS用を除く)あり、作るものは用途で決まります。モデルを呼び出すだけなら bedrock-runtime、ナレッジベースやエージェントを使うなら bedrock-agent-runtime なども必要です。プライベートDNSを有効にすれば、アプリのコードは変えずに済みます。さらに、エンドポイントに「エンドポイントポリシー」を付けると、そこを通して呼べる操作を絞れます(VPCエンドポイントの公式手順)。
社内拠点からは、専用線(Direct Connect)かVPNでVPCにつなぎます。これで「社員のPC→社内網→自社VPC→Bedrock」が一本の閉じた経路になります。
② 権限:使うモデルを先に絞る
Bedrockでは、多くのモデルが「最初に呼び出した時点で自動的に使える状態」になります。 以前のように、管理画面で1つずつ利用申請する方式ではありません。便利な反面、社内で認めていないモデルも、権限さえあれば呼べてしまいます。
公式ドキュメントは、使わせたくないモデルを止めるには、組織全体のポリシー(SCP)かIAMで bedrock:InvokeModel を拒否するよう案内しています。「許可したモデルだけを呼べる」状態をIAMとSCPで最初に作るのが、ルールを守らせる一番確実な方法です。なお、Anthropic社のモデルは初回に利用目的の申告(フォーム)が必要です(モデルアクセスの公式説明)。
③ 所在:推論プロファイルで処理する場所を選ぶ
Bedrockには、混雑時に別のリージョンで処理を分散する「クロスリージョン推論」があり、どの範囲まで分散させるかを推論プロファイルで選びます。 ここを理解しないと、「東京リージョンを使っているから国内で処理されている」という思い込みが生まれます。
| 呼び出し方 | 処理される場所 | 向いている場面 |
|---|---|---|
| リージョン単体 | 指定したリージョンのみ | 対応モデルがあり、量が少ないとき |
| 日本国内(jp.) | 東京・大阪 | 「国内で処理」が社内要件のとき |
| 地域(apac.など) | アジア太平洋の複数リージョン | 国外処理を許容し、安定性を重視 |
| グローバル(global.) | 世界の商用リージョン | 費用を重視(約10%安い) |
※出典:クロスリージョン推論、地域内クロスリージョン推論、AWS Japan「JP Cross-Region Inference」解説(Zenn)をもとに当社作成。
注意点は2つです。1つは、日本国内で処理できるモデルは限られることです。新しいモデルはグローバルのみで提供されることもあるため、社内要件が「国内処理」なら、使いたいモデルが jp. に対応しているかを先に確認します。もう1つは、公式ドキュメントのとおり、不正利用の検知のためにデータを保存する場合、その保存先は実際に処理したリージョンになることです。
④ 記録:呼び出しログは自分で有効にする
誰がいつBedrockを呼んだかはAWS CloudTrailに残りますが、プロンプトと回答の中身まで残す「モデル呼び出しログ」は、自分で有効にしない限り記録されません。 情報漏えいの調査や、回答品質の検証に使うなら、保存先(S3やCloudWatch Logs)と保存期間を決めて最初から有効にしておきます。
クロスリージョン推論で実際にどこで処理されたかも、CloudTrailの記録で確認できます。記録の中身には業務データが含まれるため、ログの閲覧権限も絞っておきましょう。
Azure OpenAI・ローカルLLMとどう選び分けますか?
判断の軸は、「社内のシステムがどのクラウドにあるか」と「データを社外の設備に出してよいか」の2つです。
| 選択肢 | 向いている企業 | 主な注意点 |
|---|---|---|
| Amazon Bedrock | 基幹システムや文書がAWSにある | 国内処理できるモデルが限られる |
| Azure OpenAI | Microsoft 365・Azureが中心 | 使えるモデルはOpenAI系が中心 |
| ローカルLLM | データを一切社外の設備に出せない | 機器の用意と運用を自社で抱える |
当社が閉域網での生成AI活用を提案する際も、まず「データを社外の設備に出してよいか」を確認し、出せないならローカルLLM、出せるなら既存のクラウドに合わせてBedrockかAzure OpenAI、という順で絞り込んでいます。ローカルLLMの詳細はローカルLLM(オンプレ生成AI)の導入|機密データを外に出さない選択肢を参照してください。
Amazon Bedrock導入はどんな手順で進めればよいですか?
「業務を決める→4点チェックで基盤を作る→1業務でPoC→運用ルールを決めて展開」の5ステップで進めます。
- 対象業務と合格基準を決める:どの業務で、何問中何問正しく答えれば合格か、どうなったらやめるかを書き出す。
- アカウントと権限を用意する:生成AI用のAWSアカウントを分け、IAMとSCPで使うモデルとリージョンを絞る。
- 閉域の経路と記録を作る:VPCエンドポイント、社内からの接続、呼び出しログの保存先を用意する。
- 1業務でPoCを行う:社内文書を使うならナレッジベースでRAGを作り、合格基準で評価する。
- 運用ルールを決めて広げる:費用の監視、利用ルール、モデル更新への追従の担当を決めてから利用者を増やす。
ステップ1が曖昧なまま基盤づくりに入ると、「動いたが、本番に出してよいか誰も判断できない」状態で止まります。PoCの設計は生成AIのPoCの進め方|失敗しない設計とKPI・撤退基準、RAGの作り方はRAG構築の進め方|社内文書を生成AIで検索するで詳しく扱っています。
Bedrockの費用はどう決まりますか?
基本は、モデルごとの入力・出力の量(トークン)に応じた従量課金です。 そこに、処理の急ぎ具合に応じた割引・割増と、周辺部品の料金が加わります。
| 料金の種類 | 内容 |
|---|---|
| オンデマンド | 使った量だけ払う標準の方式 |
| バッチ推論 | 急がない大量処理。対象モデルはオンデマンドより50%安い |
| サービス階層 | Flex(急がない処理を割安に)/Priority(優先処理を割増で) |
| プロビジョンドスループット | 処理能力を時間単位で確保する。大量・安定利用向け |
| 周辺の料金 | ガードレール、ナレッジベース、VPCエンドポイント(時間課金)などは別料金 |
※出典:Amazon Bedrock 料金(2026年10月確認)。単価はモデルとリージョンで異なるため、最新の公式ページで確認してください。
見落としやすいのは、閉域構成そのものにかかる費用です。VPCエンドポイントは利用量にかかわらず時間単位で課金されるため、PoCの見積もりにも入れておきます。PoCから本番までの費用の全体像は生成AI導入の費用相場|PoC・本番開発の内訳と見積もりの考え方を参照してください。
Bedrock導入でつまずきやすいポイントは?
つまずきの多くは、モデルの性能ではなく「AWSの組織ルールとBedrockの仕様のすれ違い」で起きます。 公式ドキュメントと構築記事で確認できる、事前に避けられるものを挙げます。
- リージョン制限のSCPで推論が失敗する:東京以外を禁止するSCPがあると、大阪へ振り分ける
jp.の推論が失敗します。推論プロファイル向けの例外を設けます。 - IPアドレス条件が効かない:VPCエンドポイント経由の通信には送信元IPの情報が入らないため、「社内IPからのみ許可」というIAM条件は成立しません。VPCエンドポイントの条件で制御します。
- 使わせたくないモデルが呼べてしまう:前述のとおり初回呼び出しで自動的に有効になるため、拒否のポリシーを先に置きます。
- 国内処理の要件と使いたいモデルが合わない:最新モデルがグローバルのみのことがあります。要件と候補モデルを最初に突き合わせます。
- 運用の担当がいない:モデルの更新、費用、ログの確認を誰が見るかが決まらないまま広げると、半年後に止まります。運用の考え方は生成AIの運用・保守の進め方|PoCの後に必要な監視・更新・改善の体制にまとめています。
よくある質問(FAQ)
Q. Amazon Bedrockに入力したデータは学習に使われますか?
A. 使われません。AWSは、入力と出力を基盤モデルの改善に使わず、モデルの提供元にも共有しないと公式に明記しています。ただし、通信経路・権限・記録の設定は利用企業の責任です。
Q. Amazon Bedrockは日本国内だけで処理できますか?
A. 東京・大阪だけを宛先にする日本国内の推論プロファイル(jp.)を使えば可能です。ただし対応モデルは限られるため、使いたいモデルが対応しているかを事前に確認してください。
Q. Bedrockを閉域網で使うには何が必要ですか?
A. 自社のVPCにBedrock用のVPCエンドポイント(AWS PrivateLink)を作り、社内拠点とVPCを専用線かVPNでつなぎます。これでインターネットを経由せずに呼び出せます。
Q. Amazon BedrockでClaudeは使えますか?
A. 使えます。Anthropic社のClaudeはBedrockの主要なモデルの1つです。初回のみ、利用目的を申告するフォームの提出が必要です。
Q. Bedrockの導入にはどのくらいの期間がかかりますか?
A. 閉域の基盤づくりと1業務のPoCで、数週間から2か月程度が目安です。期間を左右するのは技術よりも、対象業務と合格基準、社内のセキュリティ審査の進め方です。
Bedrockの導入を、PoC計画から始めませんか
Bedrockは、構成の考え方さえ決まれば短期間で試作できる基盤です。逆に、対象業務と合格基準が曖昧なまま始めると、閉域の基盤だけができあがり、「何に使うのか」で止まります。
試作の前に「どの業務で、何問に正しく答えれば合格か、どうなったらやめるか」を書き出しておくと、モデルの選定も、国内処理にこだわるべきかの判断も数字でできます。その書き出しに使える「生成AI PoC企画テンプレート」を、キュリオシティでは無料で配布しています。
- 生成AI PoC企画テンプレートを無料でダウンロードする
- 「どの業務から始めるか」「BedrockとAzure OpenAIのどちらがよいか」を一緒に整理したい方は、無料相談からお気軽にご相談ください。現場の業務を見たうえで、Bedrockで作るべきか、別の手段がよいかを率直にお伝えします。
社内向け生成AIの全体像は社内向け生成AIの構築方法|RAGと社内データ活用もあわせてご覧ください。
監修:大槻 伸夫(キュリオシティ株式会社 代表取締役CEO)
業務改善・PMI・生成AI導入の現場支援に携わる。「現場主義 × AI」を掲げ、業務の可視化から生成AIの試作・定着までを一気通貫で支援している。