


「顧客名簿を貼り付けて要約させたい」「面談メモをそのままAIに整理させたい」——生成AIが業務に浸透するほど、個人情報をプロンプトに入れてよいのかという判断が現場に突きつけられます。便利さの裏で、気付かないうちに個人情報保護法に触れるリスクがあるのが生成AIの怖さです。
本記事は、生成AIと個人情報保護の関係を「法律」「個人情報保護委員会の見解」「実務の守り方」の3点で整理し、業務でプライバシーを守るための入力ルールと運用の仕組みまで、現場で使える形にまとめました。情報漏えい全般の対策は「生成AIのセキュリティ対策|情報漏えいを防ぐ社内導入の要件」で扱っており、本記事は個人情報・プライバシーに特化して深掘りします。
結論(40字で):個人情報は「利用目的の範囲内」かつ「学習に使われない経路」でのみ入力可。原則はマスキングです。
生成AIに個人情報を入力してもいい?
個人情報の入力そのものが直ちに違法になるわけではありません。 ただし、無条件でよいわけでもありません。入力してよいのは、次の3つのゲートをすべて通過するときだけです。ひとつでも満たさなければ、原則は入力しない(マスキングして入れる)が安全側の判断になります。これをキュリオシティでは「入力可否の3ゲート」と呼んでいます。
| ゲート | 問い | 通過条件 |
|---|---|---|
| ①目的 | その入力は取得時の利用目的の範囲内か | 範囲内。範囲外なら不可 |
| ②経路 | プロンプトが学習に使われない経路か | API・法人プラン等で学習不使用を確認済み |
| ③本人 | 第三者提供・外国提供に本人同意 or 委託が要るか | 同意取得済み、または委託+基準適合体制が整備済み |
多くの現場でつまずくのは②です。無料の個人向けプランは、入力内容がモデルの改善(学習)に使われる設定になっている場合があり、この経路で顧客の個人データを入れると、後述する「第三者提供」の問題に直結します。まず個人情報はマスキングして入れるを初期設定にし、どうしても実データが必要な業務だけ、3ゲートを満たす環境を用意する——この順番が、止まらずに安全を確保する近道です。
なぜ問題になる?個人情報保護法から見た3つの論点
生成AIと個人情報保護の論点は、突き詰めると次の3つに整理できます。いずれも「AIだから特別」なのではなく、既存の個人情報保護法をプロンプト入力という新しい行為に当てはめたものです。
論点1:プロンプト入力は「第三者提供」になりうる
顧客情報などの個人データをプロンプトに入力し、そのAIサービス提供事業者が入力内容を機械学習に利用する場合、利用者から提供事業者への「提供」(個人データを自己以外の者が利用可能な状態に置くこと)と評価されうる、というのが実務上の有力な理解です(牛島総合法律事務所の解説等)。提供に当たるなら、原則として本人の事前同意が必要になります。
例外として、①適切な委託契約に基づき、②提供先が個人情報保護法第4章第2節相当の措置を継続的に講じる「基準適合体制」を確保していれば、本人同意なしでも許容される道があります(法27条5項1号・法28条)。海外事業者への提供は「外国にある第三者への提供」(法28条)の規律も重なるため、より慎重な確認が要ります。
論点2:取得時の「利用目的の範囲」を超えていないか
すでに取得済みの個人情報をプロンプトに入れる場合、その利用が取得時に特定した利用目的の範囲内でなければなりません。「採用選考のために取得した履歴書」を、無関係な用途でAIに分析させれば、目的外利用の問題が生じます。範囲を超える利用が必要なら、利用目的の変更手続や、仮名加工情報など別の制度設計を検討します。
論点3:要配慮個人情報を不用意に扱っていないか
病歴・障害・犯罪歴などの要配慮個人情報は、取得に原則として本人同意が必要な、より機微な情報です。健康診断結果や事故報告をそのままAIに投げる運用は、取得・提供の両面でリスクが高い領域です。要配慮個人情報は「そもそも入れない」を大原則にしてください。
個人情報保護委員会は何を注意喚起している?
個人情報保護委員会(PPC)は2023年6月2日、生成AIサービスの利用に関する注意喚起を公表しました。 利用者(個人情報取扱事業者)向けと、開発・提供事業者(OpenAI等)向けの2本立てです。これは生成AIと個人情報を語るうえで外せない一次情報です。
利用者(個人情報取扱事業者)への注意喚起の核心は1点です。
個人情報取扱事業者が生成AIサービスに個人情報を含むプロンプトを入力する場合には、特定された当該個人情報の利用目的を達成するために必要な範囲内であることを十分に確認すること。
つまり委員会は、前章の論点2(利用目的の範囲)を明確に求めています。さらに提供事業者に対しては、あらかじめ本人の同意を得ないで要配慮個人情報を取得しないこと、学習用データの収集時に要配慮個人情報が含まれないよう取り組み・即時に減少させる措置・発覚時の削除や非識別化を求めています。
現場が押さえるべきは、「委員会は生成AIの利用を禁じてはいない。だが目的の範囲内で・要配慮情報は入れず・学習利用を確認して使え、と釘を刺している」という点です。ルール作りはこの3語を軸にすると、公的見解と齟齬なく設計できます。
業務で入れてよい情報・ダメな情報はどう切り分ける?
まず「入れてはいけない情報」を5つに固定し、それ以外を原則許可にするのが、現場が迷わない切り分け方です。ホワイトリスト(許可を列挙)よりブラックリスト(禁止を列挙)のほうが、業務の幅を狭めずに事故を防げます。
入力禁止5分類
- 顧客の個人情報:氏名・住所・電話番号・メールアドレス・購入履歴など
- 社員の個人情報:履歴書・人事評価・給与・健康情報など(要配慮個人情報を含む)
- 社外秘の経営情報:未公開の財務、M&A、人事計画など
- 認証情報:APIキー・パスワード・DB接続情報など
- NDA対象情報:秘密保持契約下の取引先情報・技術情報
このうち1・2は個人情報保護の直撃領域、3〜5は情報セキュリティの領域です(3〜5の全体像は「生成AIのセキュリティ対策」を参照)。
どうしても人に関する情報を扱うなら、マスキングして入力します。
| 元の情報 | 変換後 |
|---|---|
| 氏名(田中太郎) | A様 / 顧客A |
| 社名(〇〇商事) | X社 |
| 電話・メール・住所 | 削除、または[マスク] |
| 社員ID・口座番号 | 削除 |
「A様は3月に解約希望を出した」のように、個人を特定できない状態にすれば、要約や文面作成といったAIの利点はほぼ損なわずに使えます。これが業務を止めずにプライバシーを守る、最も費用対効果の高い一手です。
プライバシーを守る入力ルールはどう作る?
入力段階のルールは、次の実践6原則に落とすと現場に定着します。 抽象的な禁止文ではなく、行動として書き切るのがコツです。
- 原則マスキング:人に関する情報は伏せ字・記号化してから入力する
- 要配慮情報はゼロ入力:健康・病歴・障害・犯罪歴は例外なく入れない
- 経路を固定:会社が承認した法人プラン/APIのみ使用。個人プランでの業務利用は禁止
- 学習不使用を確認:使うサービスが入力を学習に使わない設定・契約かを事前確認し、記録する
- 目的の範囲内で使う:取得時の利用目的を超える分析はしない
- 出力も点検:AIの回答に他者の個人情報や誤情報(ハルシネーション)が混ざっていないか確認してから使う(ハルシネーション対策)
契約プランの選び方も重要です。一般に、個人向け無料・Plusプランは業務での個人情報入力に不向き、ChatGPT Team/Enterpriseなどの法人プランは設定次第で可、API(Zero Data Retentionなどデータ非保持の設定)が最も安全とされます。「安いから」で個人プランを全社に配ると、経路(ゲート②)で破綻します。
運用と仕組みでどう守る?
ルールを人の善意に依存させないため、仕組みで守るのが本命です。 キュリオシティでは、入力・経路・出口の「守りの3層」で設計します。ここは私たちの閉域網で生成AIを使うPoC支援で繰り返し実装してきた勘所です。
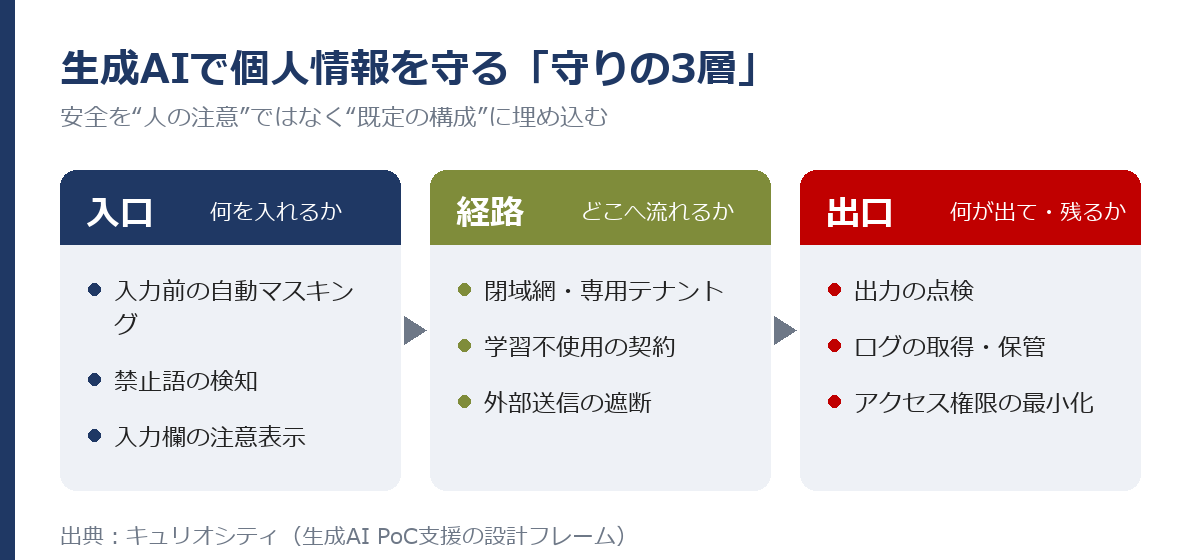
| 層 | 守る対象 | 打ち手の例 |
|---|---|---|
| 入口 | 何を入れるか | 入力前の自動マスキング/禁止語検知/プロンプト入力欄の注意表示 |
| 経路 | どこへ流れるか | 閉域網・専用テナントでの実行、学習不使用の契約、外部送信の遮断 |
| 出口 | 何が出て・残るか | 出力の点検、ログの取得・保管、アクセス権限の最小化 |
一次情報:閉域網PoCで効いた「データ分離」と「入力制限」
ある中堅の製造・流通系企業で、社内文書を生成AIで検索・要約できるようにする閉域網PoC(社内ネットワークで完結し、外部の汎用AIサービスにデータを出さない構成)を支援した際の、匿名化した知見を共有します。
課題は「便利さと安全のどちらも譲れない」という典型的なジレンマでした。現場は顧客対応の履歴や見積を扱いたい一方、情報システム部門は個人情報の外部流出を絶対に避けたい。ここで効いたのが2つの設計でした。
- データ分離:AIが参照する社内データを、個人情報を含む領域と含まない領域に分け、通常業務では非個人情報の領域だけを検索対象にした。個人情報を含む領域は、権限を持つ担当者が明示的に切り替えたときだけ参照可能にした(この「参照範囲の設計」はRAG構築の肝でもあります)。
- 入力制限:プロンプト入力欄の手前で、電話番号・メールアドレス・マイナンバー様式などのパターンを検知し、送信前に警告・マスキングを促す仕組みを噛ませた。
結果として、現場は「マスキングを毎回手作業でやる」負担から解放され、情報システム部門は「個人情報は既定では経路に乗らない」という安心を得られました。安全を”人の注意”ではなく”既定の構成”に埋め込む——これが、生成AIで個人情報保護を継続できるかどうかの分岐点だと、現場で何度も実感しています。技術構成の全体像は「社内向け生成AIの構築方法」も参照してください。
社内規程・運用へどう落とし込む?
ルールと仕組みは、規程・教育・点検の順で組織に定着させます。 次の4ステップが最短です。
- 入力禁止情報とマスキング手順を規程化する:前述の5分類・6原則・置換ルールを、生成AIの社内利用規程に明記する(作り方は「生成AI 社内利用規程の作り方」)。盛り込む項目は、利用可能サービス/利用可能な業務範囲/入力禁止情報/マスキング手順/新サービス申請ルート/出力確認責任/違反時対応の7点。
- 承認済みの経路を用意する:法人プランや閉域網環境を整備し、「これを使えば個人情報保護の要件を満たす」既定の道を作る。
- 教育で判断力を配る:規程を配って終わりにせず、「この情報は入れてよいか」を自分で判断できるよう研修する(生成AIの社員研修)。
- ログで点検し改善する:利用ログを定期点検し、ヒヤリハットを規程・仕組みへ反映する。個人情報保護は一度作って終わりではなく、運用で締め直すものです。
小さく始めるなら、PoC(試行導入)で「入力制限・データ分離」を実地検証し、効果と課題を見極めてから全社展開するのが安全です。設計・KPI・撤退基準の立て方は「生成AI開発・PoC支援」にまとめています。
よくある質問(FAQ)
Q. 生成AIに個人情報を入力するのは違法ですか?
A. 入力そのものが直ちに違法になるわけではありません。ただし、利用目的の範囲を超える、本人同意なく学習に使われる経路で第三者提供にあたる、要配慮個人情報を同意なく扱う、といった場合に個人情報保護法違反となりえます。原則はマスキングして入れるのが安全です。
Q. ChatGPTに入れた情報は学習に使われますか?
A. プランや設定によります。個人向けの無料プランは入力が学習に使われる場合があり、法人プランやAPIでは学習に使わない設定・契約が選べます。業務では「学習に使われない経路」を事前に確認し、記録してください。
Q. マスキングすれば個人情報保護法の問題はなくなりますか?
A. 氏名・連絡先などを除き、個人を特定できない状態にできれば、個人情報としての多くのリスクは下がります。ただし、断片情報の組み合わせで特定されうるケースもあるため、「特定できないか」を都度確認することが大切です。
Q. 個人情報保護委員会は生成AIの利用を禁止していますか?
A. 禁止していません。2023年6月の注意喚起は、利用目的の範囲内で使うこと、要配慮個人情報を不用意に扱わないこと等を求める内容で、適切に使う前提での利用を否定していません。
Q. 一番安全な使い方は何ですか?
A. 閉域網や専用テナントでデータを外部に出さず、個人情報を含むデータは既定では経路に乗せない「データ分離」構成にすることです。汎用サービスを使う場合は、法人プラン+学習不使用の確認+マスキングの3点を必須にしてください。
まとめ
生成AIと個人情報保護の要点は、「利用目的の範囲内で・要配慮個人情報は入れず・学習に使われない経路で使う」の3語に集約されます。個人情報保護委員会の注意喚起もこの線に沿っています。現場では、入力禁止5分類とマスキングをルール化し、閉域網・データ分離で”既定の安全”を仕組みに埋め込み、規程・教育・ログ点検で継続する——この流れが、便利さを止めずにプライバシーを守る現実解です。
キュリオシティは”現場主義 × AI”で、閉域網PoCから社内規程の整備まで、個人情報を守りながら生成AIを業務で使える形に落とし込む支援をしています。
無料ダウンロード:生成AI PoC企画テンプレート
個人情報保護の要件を織り込んだPoC設計の型を、そのまま使えるテンプレートで配布しています。
▶ テンプレートを無料で受け取る自社の業務にどう適用するか相談したい方は、無料相談はこちらからお問い合わせください。
監修:大槻 伸夫(キュリオシティ株式会社 代表取締役CEO)。本記事は個人情報保護委員会の公表資料および実務解説をもとに、当社の生成AI PoC支援の知見を加えて作成しています。個別の法的判断については、必要に応じて専門家にご相談ください。
