「社内文書をRAGで検索できるようにしたのに、『この1年で多かったクレームの傾向は?』と聞くと的外れな答えが返ってくる」——RAGを入れた企業から、こうした相談を受けることが増えました。そこで名前が挙がるのがGraphRAG(グラフRAG)です。
GraphRAGとは、文書の中に出てくる人・物・出来事の「つながり」を先にグラフ(関係の地図)として整理し、そのつながりをたどって回答するRAGの方式です。複数の文書をまたぐ質問や、全体の傾向を問う質問に強い一方、作るための費用と手間は通常のRAGより大きくなります。
本記事では、Microsoft Researchの論文・公式リポジトリ(2026年10月確認)と、当社が自社の業務ナレッジ(約700件のノート)をグラフとして分析した実測をもとに、GraphRAGの仕組み、通常のRAGとの違い、向いている業務、導入するかどうかの判断方法を整理します。
この記事の監修:大槻 伸夫(キュリオシティ株式会社 代表取締役CEO)。業務改善・PMI・生成AI導入の現場支援に携わり、「現場主義 × AI」で業務の可視化から生成AIの試作・定着までを支援。
GraphRAGとは何ですか?
GraphRAGは、RAG(検索拡張生成)の「検索」の部分を、文章の似ている度合いではなく、言葉どうしの関係で行う方式です。 Microsoft Researchが2024年4月に論文「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」を公開し、同年に実装をオープンソースとして公開したことで広く知られるようになりました。
通常のRAGは、質問と「意味が近い」文章の断片を探してきて、生成AIに渡します。これは「規程の第何条に何と書いてあるか」のように、答えがどこか1か所に書いてある質問には強い仕組みです。
ところが、論文が指摘するとおり、「このデータ全体の主なテーマは何か」のように、文書全体を見渡さないと答えられない質問には弱いという限界があります。答えがどの1か所にも書かれていないため、似ている断片をいくら集めても全体像にならないからです。GraphRAGはこの弱点を埋めるために作られました。
なお、RAGそのものの基本はRAG構築の進め方|社内文書を生成AIで検索するで解説しています。
通常のRAGとGraphRAGは何が違いますか?
違いは「事前に何を作っておくか」と「何をたどって探すか」の2点です。 通常のRAGは文書を細かく切って保存しておくだけですが、GraphRAGは生成AIに文書を読ませて「誰が・何が・どう関係しているか」を抜き出し、関係の地図とその要約まで先に作っておきます。
| 比べる点 | 通常のRAG | GraphRAG |
|---|---|---|
| 事前に作るもの | 文書の断片と、その意味の数値(ベクトル) | 断片に加えて、人・物・出来事とその関係のグラフ、まとまりごとの要約 |
| 探し方 | 質問と意味が近い断片を探す | 関係をたどる/まとまりの要約を読む |
| 得意な質問 | 答えが1か所に書いてある質問 | 複数の文書をまたぐ質問、全体の傾向を問う質問 |
| 作る費用 | 小さい | 大きい(文書を全部、生成AIに読ませるため) |
| 文書の追加・更新 | 追加分だけ処理すればよい | 関係とまとまりの作り直しが必要になりやすい |
ひとことで言えば、通常のRAGは「索引付きの書庫」、GraphRAGは「人物相関図と章ごとのあらすじが付いた書庫」です。あらすじがあるので全体の話はしやすくなりますが、相関図とあらすじを作るのに手間がかかります。
GraphRAGはどのような仕組みで動きますか?
公式ドキュメントによると、GraphRAGは「索引を作る4工程」と「質問に答える4つの検索方式」で構成されています。
索引を作る4工程
- 文書を分ける:文書を分析しやすい単位に切り分ける(ここは通常のRAGと同じ)
- 関係を抜き出す:生成AIが各単位を読み、登場する人・物・出来事(エンティティ)と、それらの関係、主な主張を抜き出す
- まとまりを見つける:抜き出した関係をグラフにし、「Leiden法」という計算手法で、よくつながっている集まり(コミュニティ)を階層的に見つける
- まとまりごとに要約する:各コミュニティの中身を、下の階層から順に生成AIが要約しておく
質問に答える4つの検索方式
- Global Search(全体検索):コミュニティの要約を読んで、データ全体に関する質問に答える
- Local Search(局所検索):特定の人・物を起点に、つながっている相手や関連情報を広げて答える
- DRIFT Search:局所検索に、コミュニティの要約という「周辺の文脈」を加えて答える
- Basic Search:通常のRAGと同じく、意味の近さで断片を探す
つまりGraphRAGは、通常のRAGを置き換えるものではなく、通常のRAGの上に「関係の地図」と「まとまりの要約」を追加したものと捉えると分かりやすくなります。
GraphRAGが強い質問・弱い質問は何ですか?
GraphRAGが強いのは「横断」と「俯瞰」の質問で、単純な事実確認ではむしろ通常のRAGのほうが正確なことがあります。 これを示す公開データとして、個人の文書約1万件で250問を比べた検証(Qiita、2026年6月)があります。
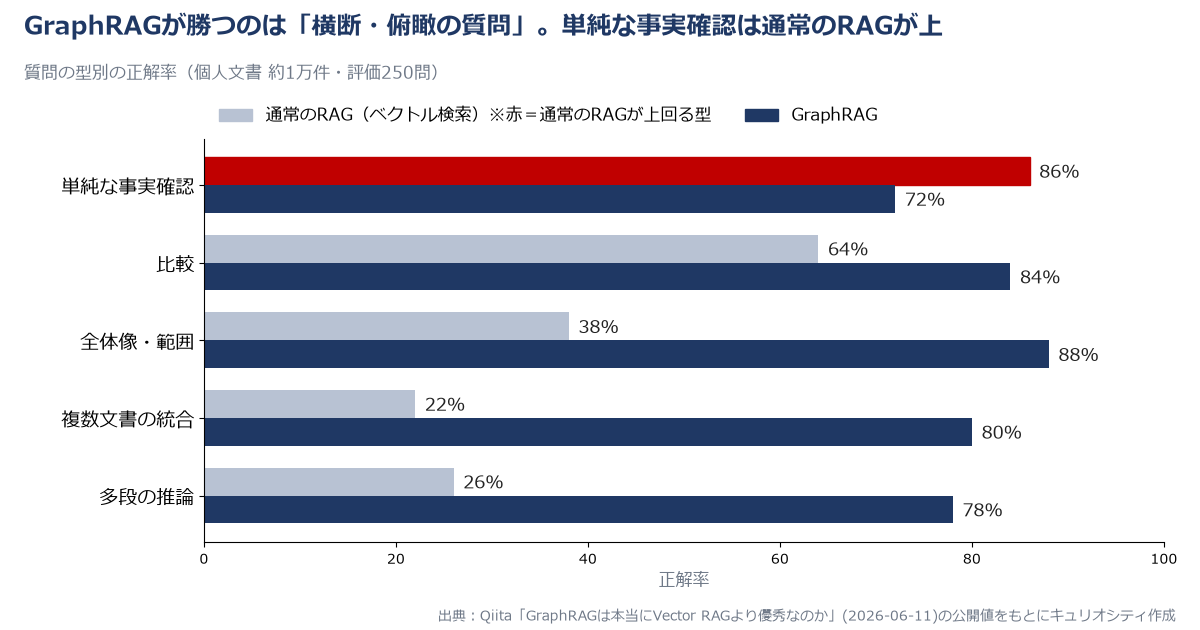
総合の正解率は通常のRAGが47%、GraphRAGが80%でした。ただし質問の型ごとに見ると、結果ははっきり分かれます。
- GraphRAGが大きく勝つ:全体像・範囲を問う質問(38%→88%)、複数文書の統合(22%→80%)、多段の推論(26%→78%)
- 通常のRAGが勝つ:単純な事実確認(86%対72%)
単純な事実確認でGraphRAGが負けるのは、関係やまとまりの要約を経由するぶん、原文の細かい表現が抜け落ちやすいためと考えられます。「総合で80%だからGraphRAGが上」とは言えず、自社の利用者がどの型の質問をするかで答えが変わるというのが、この数字から読み取るべき点です。
自社のナレッジをグラフにしてみて、何が分かりましたか?
当社は、会議録・案件メモ・調査ノートを相互リンクで結んだ社内ナレッジ基盤を日常的に運用しています。 ノートどうしをリンクでつないでいるため、これはそのまま「人が手で作ったナレッジグラフ」です。GraphRAGを検討する前提として、このグラフを実際に計算してみました(2026年10月時点、ノート710件・つながり3,173本)。分かったことは3つです。
1. 「何でもつながる中心」があると、2歩たどるだけで全体が出てくる
ある案件のノートから、リンクを2歩たどった範囲を数えると、710件中689件(97%)が出てきました。原因は、全ノートにリンクを張っている索引ノート(つながり660本)のような「中心」のノートです。これを経由すると、関係のないノートまで一気に届いてしまいます。
つながりの多い上位5件を経由しないようにすると、同じ案件から2歩で届くのは149件、別の案件では78件まで絞り込めました。グラフをたどる検索は、中心となる言葉(社名・部署名・「顧客」などの一般語)の扱いを決めないと、関係のないものまで拾ってしまいます。 GraphRAGが関係をただたどるのではなく、まとまり(コミュニティ)単位で要約を作る設計になっているのは、この問題への答えでもあります。
2. 自動で見つけた「まとまり」は、業務の区切りと一致しない
同じグラフに、GraphRAGと同系統のコミュニティ検出(Louvain法)をかけると、20のまとまりに分かれました。記事制作の仕組み、資金繰り・人事、特定のコンサル案件など、業務の単位とおおむね重なるまとまりもあった一方、新規事業・特許・財務のノートが1つのまとまりに混ざるケースも出ました。同じ時期に同じ会議で話したため、リンクが密になっていたのです。
GraphRAGの「全体検索」は、このまとまりの要約を読んで答えます。まとまりが業務の区切りとずれていれば、要約もずれます。 本番で使うなら、自動で作られたまとまりを業務の担当者が一度見て、「この括りで要約されて困らないか」を確認する工程が必要だと考えています。
3. キーワード検索とグラフは、拾うものが違う
ある案件名を含むノートをキーワードで探すと78件、その案件ノートと直接リンクしているノートは51件でした。キーワードで見つかるのに、リンクがないノートが多数あります。逆に、案件名を含まないのにリンクでつながっていた関連ノートも、案件によって1〜4件ありました。
グラフは「誰かが関係として抜き出したもの」しか知りません。 GraphRAGでは抜き出しを生成AIが行いますが、抜き出し漏れがあれば、その情報は関係の地図に現れません。公式の実装にも通常のRAGと同じ検索方式(Basic Search)が残されているのは、両方を併用する前提だからです。
費用と手間は通常のRAGとどれくらい違いますか?
作る費用は桁違いに大きくなる、と考えておくのが安全です。 公式リポジトリの説明文にも「索引作成は高くつく処理になりうるため、手順と費用を理解し、小さく始めること」と警告が書かれています。
先ほどと同じ検証者による、文書1万件での実測(Qiita、2026年7月)は次のとおりです。
| 項目 | 通常のRAG | GraphRAG | 倍率 |
|---|---|---|---|
| 索引を作る時間 | 約4分 | 約11時間 | 約165倍 |
| 索引を作るAPI費用 | 約0.2ドル | 約14ドル | 約70倍 |
| 1回の回答にかかる時間 | 約0.4秒 | 約3.8秒 | 約9.5倍 |
金額だけを見ると小さく感じますが、これは軽量なモデルでの数字です。社内文書が増えたり、更新のたびに作り直したりすれば、費用と待ち時間はそのまま積み上がります。
あわせて押さえておきたいのが、次の3つの動きです。
-
他の実装の広がり:入口で対象を絞ってから関係をたどる「LightRAG」など、費用と更新のしやすさを重視した実装が出ています。先の正解率の検証でも、LightRAGは総合66%と通常のRAG(47%)とGraphRAG(80%)の中間でした。グラフデータベース(Neo4jなど)の提供元も、GraphRAG向けの部品を公開しています。
-
軽量版の登場:Microsoft Researchは2024年11月に「LazyGraphRAG」を発表し、索引作成の費用を通常のRAGと同等、つまりフル版GraphRAGの0.1%に抑えたと報告しています。関係の抜き出しを事前に全部やらず、質問が来たときに必要な分だけ行う考え方です。
- 公式実装は保守中心に:公式のGitHubリポジトリは、2026年10月時点で「おおむね保守モードで、新機能の追加は行わない」と明記しています。バグ修正のリリース(v3.3.0、2026年10月)は続いていますが、新しく作るなら、公式実装をそのまま使うか、軽量版や他の実装を選ぶかを、最初に決めておく必要があります。
費用の見積もりの考え方は生成AI導入の費用相場|PoC・本番開発の内訳と見積もりの考え方も参考にしてください。
GraphRAGが向いている業務・向いていない業務は?
向いているのは「関係をまたいで答える」業務、向いていないのは「1か所を正確に引く」業務です。
| 向いている業務(横断・俯瞰の質問が多い) | 向いていない業務(事実確認の質問が多い) |
|---|---|
| 問い合わせ・クレーム記録から、増えている不満の傾向をつかむ | 社内規程・就業規則の条文を引く |
| 設計変更・不具合の記録から、ある部品の変更が影響する製品を洗い出す | 製品マニュアルの手順や仕様値を答える |
| 契約書群から、特定の取引先に関わる条項を横断で確認する | 申請書の書き方や締め切りを答える |
| 議事録の蓄積から、繰り返し出ている論点と決定の経緯をたどる | 社内FAQの定型的な質問に答える |
| 調査レポート群から、テーマごとの主な論点を要約する | 1つの文書の中の数字を確認する |
右側の業務で精度が出ない場合、原因の多くはGraphRAGの有無ではなく、文書の分け方や検索の組み立てにあります。まずはRAGの精度を上げる方法|検索精度・回答品質を改善する打ち手やRAGのチャンク設計のコツ|検索精度を左右する文書分割とメタデータの打ち手を先に試すほうが、費用対効果は高くなります。
GraphRAGを導入すべきかはどう判断しますか?
当社では、技術の比較から入らず、「利用者が実際にする質問」を型に分けて判断しています。 これを「質問の型テスト」と呼んでいます。
- 質問を集める:今のRAGの質問ログ、なければ現場の担当者に「AIに聞きたいこと」を30〜50問書き出してもらう
- 型に分ける:各質問を「事実確認」「比較」「横断(複数の文書をまたぐ)」「俯瞰(全体の傾向を問う)」の4つに振り分ける
- 今の仕組みで解かせる:通常のRAGで全問を解かせ、型ごとに正解率を出す
- 落ちている型で決める:横断・俯瞰の型で正解率が低く、しかもその質問が業務上重要なら、GraphRAG(まずは軽量版や小さな範囲)を試す。事実確認の型で落ちているなら、GraphRAGではなく文書と検索の改善に戻る
このテストの良いところは、GraphRAGを入れた後の「合格基準」もそのまま決まることです。「横断の型の正解率が○%から○%に上がれば本番に広げる、上がらなければやめる」と、事前に線を引けます。PoCの設計の考え方は生成AIのPoCの進め方|失敗しない設計とKPI・撤退基準で解説しています。
また、GraphRAGの関係の抜き出しには生成AIの誤りが混ざります。抜き出された関係そのものが誤っていると、もっともらしい誤答につながるため、生成AIのハルシネーション対策|業務で誤答を減らす設計の打ち手にある「出典の提示」は、通常のRAG以上に重要になります。
よくある質問
Q. GraphRAGとは簡単に言うと何ですか?
A. 文書に出てくる人・物・出来事の関係を先に地図(グラフ)にしておき、その関係をたどって答えるRAGです。複数の文書をまたぐ質問や、全体の傾向を問う質問に強いのが特徴です。
Q. GraphRAGは通常のRAGより精度が高いのですか?
A. 質問の型によります。公開されている検証では、全体像や複数文書の統合を問う質問で大きく上回った一方、単純な事実確認では通常のRAGのほうが正解率が高い結果でした。
Q. GraphRAGを使うのにグラフデータベースは必要ですか?
A. 必須ではありません。Microsoftの公式実装は、抜き出した関係や要約をファイルとして保存して使えます。大規模に運用したり、他のシステムから関係を参照したりする場合に、グラフデータベースを併用します。
Q. GraphRAGは日本語の文書でも使えますか?
A. 使えます。関係の抜き出しは生成AIが行うため、日本語に強いモデルを使えば対応できます。ただし、略称や表記ゆれ(同じ取引先の別表記など)が別の対象として抜き出されやすいため、名寄せの工程を入れると精度が安定します。
Q. 今のRAGをGraphRAGに作り直す必要がありますか?
A. 多くの場合、作り直しは不要です。GraphRAGは通常のRAGの上に関係の地図を足すものです。横断・俯瞰の質問が重要な範囲だけに追加し、事実確認は今の仕組みを使い続ける併用が現実的です。
GraphRAGの検討を、PoC計画から始めませんか
GraphRAGは、通常のRAGが苦手とする「全体を見渡す質問」「関係をまたぐ質問」に答えるための有力な選択肢です。ただし、作る費用は桁違いに大きく、単純な事実確認ではかえって精度が下がることもあります。導入の前に、自社の利用者がどの型の質問をしているのかを確かめることが、遠回りに見えて一番の近道です。
試作の前に「対象業務・想定する質問・合格基準・やめる条件」を1枚に書き出すための「生成AI PoC企画テンプレート」を、キュリオシティでは無料で配布しています。
- 生成AI PoC企画テンプレートを無料でダウンロードする
- 「自社の質問はGraphRAGが必要な型か」を一緒に確かめたい方は、無料相談からお気軽にご相談ください。現場の質問を見たうえで、GraphRAGを試すべきか、今のRAGの改善で足りるかを率直にお伝えします。
社内データを使う生成AIの全体像は社内向け生成AIの構築方法|RAGと社内データ活用、データの保存先の選び方はベクトルデータベースの選び方|RAG構築での比較ポイントもあわせてご覧ください。
監修:大槻 伸夫(キュリオシティ株式会社 代表取締役CEO)
業務改善・PMI・生成AI導入の現場支援に携わる。「現場主義 × AI」を掲げ、業務の可視化から生成AIの試作・定着までを一気通貫で支援している。